مقدمهای بر آزمایشهای تاریخی در هوش مصنوعی
در دهههای اخیر، مفهوم هوش مصنوعی به طور فزایندهای در حال پیشرفت است و محققان به دنبال راههایی برای توسعه سیستمهایی هستند که بتوانند از مرزهای دانش انسانی فراتر روند. یکی از پروژههای جالب توجه، محدود کردن دادههای آموزش مدلهای AI به دورهای خاص است؛ در این حالت، دادهها تنها تا سال ۱۹۱۱ در اختیار سیستم قرار میگیرند. هدف این است که بررسی شود آیا این سیستم میتواند نظریهها و کشفیات علمی آن زمان را مجدداً کشف کند یا خیر.
پیشنهاد هاسابیس و آزمایشهای مربوطه
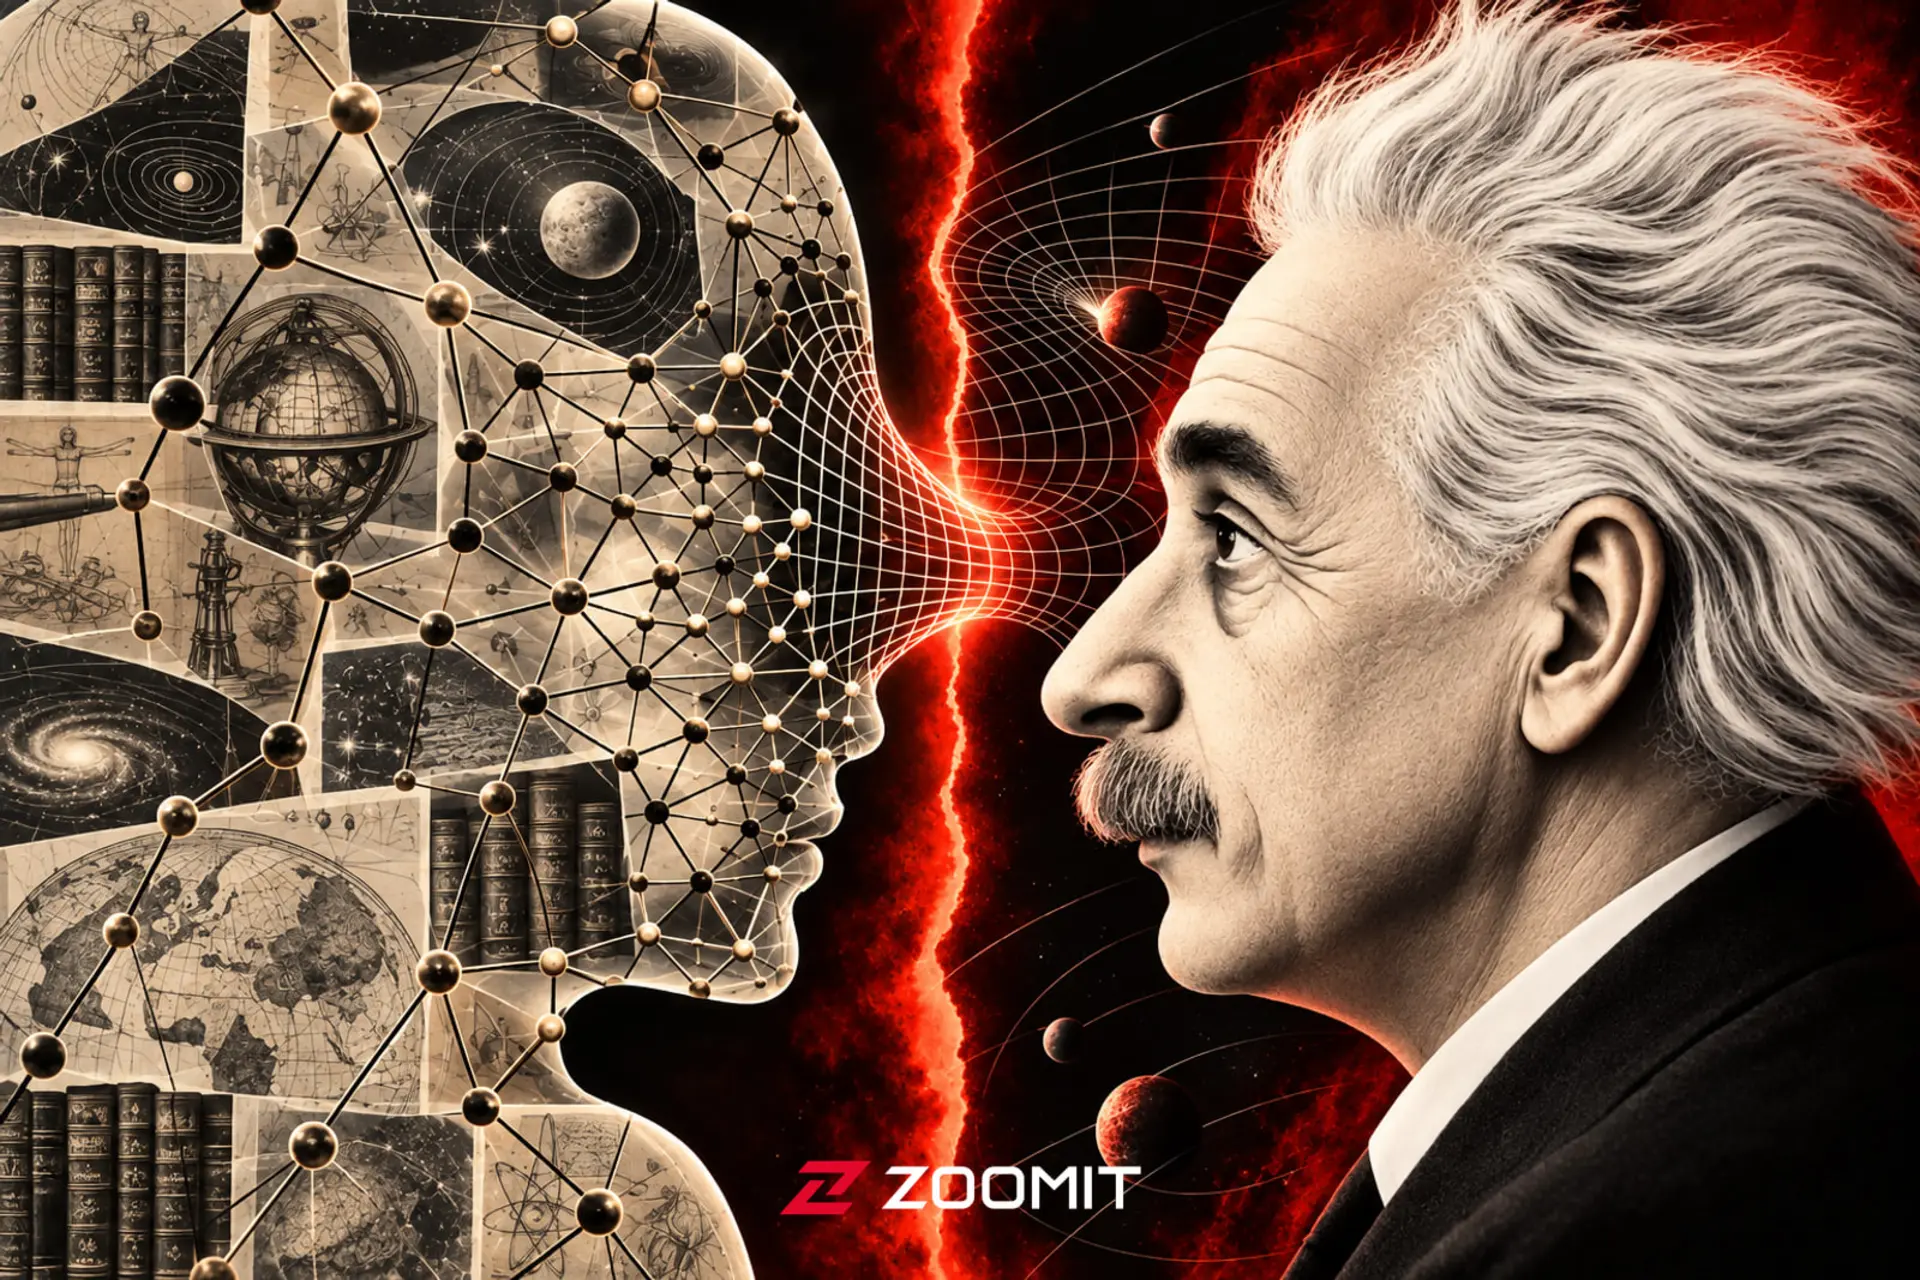
در فوریه ۲۰۲۶، دمیس هاسابیس، مدیرعامل سابق گوگل دیپمایند، در اجلاس هوش مصنوعی هند، طرحی را مطرح کرد که بسیار نوآورانه بود. او پیشنهاد داد که یک مدل زبانی بزرگ تنها با دانش و اطلاعات بشر تا سال ۱۹۱۱ آموزش داده شود و سپس مورد آزمایش قرار گیرد تا ببیند آیا میتواند نظریه نسبیت عام را مجدداً کشف کند. این آزمایش، نمونهای از تلاش برای سنجش هوش مصنوعی عمومی یا همان AGI است، مفهومی که هنوز در مرحله توسعه و تحقیق است و شرکتهای فناوری بزرگ آن را هدف نهایی رقابتهای خود میدانند.
چالشها و اهداف پروژه
در این پروژه، آموزش مدل در مرز سال ۱۹۱۱ متوقف میشود و معادلات و نظریههای اینشتین، که طی یک قرن توسعه یافتهاند، از دانش ماشین خارج میمانند. این ماشین باید راه حلهای جدید را با دانش محدود آن دوره بیابد و در مسیرهای علمی آن زمان حرکت کند. این فرآیند، نیازمند شهود، خلاقیت و درک عمیق از مفاهیم علمی است که در آن زمان شناخته میشدند.
پیشرفتهای علمی و چالشهای فنی
در کنار این پروژههای فرضی، پژوهشگران دیگری نیز در حال توسعه مدلهایی هستند که بتوانند کشفیات علمی را از دورههای مختلف بازسازی کنند. اوین ایوانز، پژوهشگر مؤسسهی Truthful AI، چند ماه قبل از سخنرانی هاسابیس، ایده مشابهی را مطرح کرد؛ در این روش، مدلهای تاریخی تنها اسناد و اطلاعات منتشر شده در یک دوره خاص را مطالعه میکنند و سپس تلاش میکنند کشفیات بعدی آن دوره را پیشبینی یا بازسازی نمایند.
این نوع فناوری، چالشهای فنی زیادی دارد؛ از جمله مدیریت حجم عظیم دادهها، کنترل حافظه مدلها و تعیین معیارهای دقیق برای تشخیص کشفهای علمی واقعی. با وجود این، پیشرفتهای اولیه نشان میدهد که ساخت چنین ماشینهایی، علیرغم دشواریهای بسیار، ممکن است روزی به واقعیت تبدیل شود و درک ما از فرآیندهای علمی و تاریخ علم را تغییر دهد.
نتیجهگیری و آیندهنگری
پروژههایی مانند محدود کردن دادههای هوش مصنوعی به دورههای خاص، نشاندهنده تلاشهای بیوقفه برای فهم بهتر فرآیندهای خلاقیت و کشف در علم است. اگر بتوانیم سیستمهایی توسعه دهیم که بتوانند نظریهها و کشفیات علمی را مجدداً کشف کنند، این امر میتواند انقلابی در آموزش، پژوهش و توسعه فناوریهای نوین باشد. آیندهی هوش مصنوعی، در گروی توانایی آن در درک عمیق مفاهیم علمی و تاریخی است، و این مسیر، همچنان پر از چالشها و فرصتهای نوین است.
مرز بین حافظه و درک مستقل در کشف علمی
در سال ۲۰۲۵، گروهی از پژوهشگران آزمون جدیدی بر اساس آزمایش اینشتین وضع کردند: «تمامی اطلاعات پیشین یک سیستم را در اختیار ماشین قرار دهید و ببینید آیا قادر است به طور مستقل دستاورد یا نتیجهای مشابه با آن را تولید کند.» این رویکرد، موفقیت در چنین آزمایشی را معادل یکی از بزرگترین دستاوردهای فکری بشر میدانند. اما باید توجه داشت که دستیابی به پاسخ صحیح صرفاً از طریق حافظه، به معنای کشف علمی مستقل نیست.
وقتی سخن از «مستقل بودن» به میان میآید، آزمایش مدلهای هوش مصنوعی پیچیدهتر میشود. ممکن است مدلی معادلات نسبیت را بر اساس متنی نادرست یا توضیحاتی غیرمستقیم به خاطر سپرده باشد، یا اینکه پژوهشگران با ارائه مقدماتی مشخص، مسیر پاسخ را در پیش پای آن قرار داده باشند. هر دو حالت میتوانند به نتیجه صحیح منجر شوند، اما این نتیجه نشان نمیدهد که مدل به صورت مستقل مسئله را حل کرده است؛ بلکه ممکن است پاسخ از حافظه مدل یا سرنخهای ارائه شده توسط پژوهشگران حاصل شده باشد.
فضای زمان و محدودیتهای آن در آزمایشهای هوشمندی مصنوعی
اگر بخواهیم یک مدل امروزی را در نقش فردی در سال ۱۹۱۱ تصور کنیم، با چالشهای زیادی روبهرو میشویم. اطلاعات آینده در فرآیند آموزش میلیاردها پارامتر در مدلها رسوب کرده است و حذف این اطلاعات نیازمند ساخت مدلی کاملاً جدید است. علاوه بر این، مجموعه دادههای آموزشی باید محدود به اسناد و مدارک آن زمان باشد. مرز میان دستکاری دادهها و خلاقیت واقعی ماشین، چالش اصلی در این نوع آزمایشها محسوب میشود.
در صورتی که سرنخهایی مانند اصل همارزی، آزمایش ذهنی آسانسور یا هندسهی خمیده در اختیار مدل قرار گیرد، مسیر حل تا حد زیادی هموار میشود. در این حالت، مدل بیشتر قطعات آماده را کنار هم قرار میدهد. اما چالش واقعی زمانی است که مدل تنها با مسئلهها، مشاهدات و دانش آن دوره روبهرو شود و خود تصمیم بگیرد کدام مسیر را در پیش گیرد.
نقش سرنخها و محدودیتهای آن در کشف نوآوری
حتی بدون دخالت حافظه و راهنماییهای مستقیم، فرآیند کشف ایدههای نوین برای یک دانشمند بسیار پیچیده است. چگونه از چند مشاهده پراکنده به مفهومی نو میرسد؟ تام زهاوی، پژوهشگر گوگل دیپمایند، برای توضیح این فرآیند، به طرح کوچکی اشاره میکند که اینشتین سالها پیش در نامهای برای یکی از دوستانش ترسیم کرده بود. این نمونه نشان میدهد که خلاقیت علمی نیازمند توانایی ترکیب و تحلیل دادههای پراکنده و ساختن تصویر کلی است، امری که هنوز برای هوش مصنوعی چالشبرانگیز باقی مانده است.
از استقرا تا فرضیهپردازی؛ چرا هوش مصنوعی به جهش اینشتینی نمیرسد؟
در تاریخ کشفهای علمی، تصاویر و طرحهای ذهنی نقش مهمی ایفا میکنند. اینشتین در نامهای به موریس سولووین، مسیر تصور شده برای پیشرفتهای علمی را با یک طرح ساده نشان داده است. در این طرح، پایین تصویر نمایی از تجربیات و مشاهدههای ما از جهان قرار داشت و بالای آن، اصول و مفاهیمی که دانشمند برای تبیین پدیدهها توسعه میداد، دیده میشد. اینشتین میان این دو خط، جهشی از مشاهدات مستقیم به سمت فرضیههای تئوریک را ترسیم میکرد؛ فرآیندی که منجر به ساختن اصول، پیشبینیها و آزمایشهای بعدی میشد.
تام زهاوی، محقق گوگل دیپمایند، این فرآیند را با کمک همان طرح سهراه متفاوت برای رسیدن به پاسخ توضیح میدهد. اولین راه، استنتاج است که بر پایه قوانین شناختهشده استوار است؛ برای نمونه، فیزیکدان با داشتن قوانین حرکت و وضعیت فعلی یک سیاره، میتواند مسیر آینده آن را محاسبه کند. راه دوم، استقرا است که بر تحلیل نمونههای متعدد تکیه دارد؛ یعنی مشاهده تعداد زیادی از سیارات و یافتن الگوهای مشترک، تا بتوان قاعده کلیتری استخراج کرد. بخش زیادی از یادگیری ماشین نیز بر همین اساس شکل گرفته است؛ مدلها حجم عظیمی از دادهها را تحلیل میکنند، الگوها را شناسایی و نمونههای بعدی را پیشبینی میکنند.
درک قوانین موجود، کار سادهای است؛ اما ساختن چارچوب فکری نو، نیازمند کشفهای واقعی است. راه سوم، زمانی ضرورت پیدا میکند که مشاهدهای با فرضیههای قبلی سازگار نباشد. در این حالت، پژوهشگر با مواجهه با دادهای جدید، فرضیه یا نظریهای تازه پیشنهاد میدهد. این فرآیند، که به آن فرضیهپردازی یا استدلال ربایشی گفته میشود، شامل حدس اولیه و سپس ساختن پیشبینیهایی است که بتوان آنها را با آزمایش و مشاهده سنجید.
همانطور که زهاوی اشاره میکند، پیشرفتهای هوش مصنوعی در حوزههای استقرا و استنتاج قابل مشاهده است. مدلها میتوانند از حجم عظیمی داده، الگوهای پنهان را شناسایی کنند، فرضیههای جدید بسازند و زنجیرههای طولانی اثبات را پیش ببرند. اما مشکل اصلی زمانی آغاز میشود که مشاهدهای با فرضیههای موجود تطابق نداشته باشد و نیاز به ایدهای نو و بنیادی احساس شود. در این مرحله، هوش مصنوعی باید توانایی تولید مفاهیم و اصول جدید را داشته باشد، کاری که هنوز در مرحله توسعه قرار دارد.
برای مثال، در قرن نوزدهم، اخترشناسان تصور میکردند که گرانش یک سیاره ناشناخته، حرکت عجیب عطارد را توضیح میدهد. این فرضیه تا زمانی که نسبیت عام آلبرت اینشتین ارائه شد، تنها یک حدس بود. اینشتین با تغییر دیدگاه و ارائه نظریهای بر پایه خمیدگی فضا-زمان، این معما را حل کرد. او نه تنها قوانین قبلی را حفظ کرد، بلکه با تغییر پارادایم، جهان را به گونهای متفاوت تفسیر کرد. این رویکرد، نشان میدهد که پیشرفت علمی، نیازمند تغییر نگاه و ساختن مفاهیم جدید است.
در حوزه هوش مصنوعی، نیز برای رسیدن به سطحی مشابه، باید توانایی ساختن مفاهیم و اصول نوین را داشت. پژوهشگران در حال ساختن جهانی مصنوعی هستند که مدلها بتوانند با نگاه کردن به حرکت سیارات، قوانینی جدید و مستقل از دادههای قبلی، ارائه دهند. این توانایی، کلیدی است برای گامی فراتر از تحلیلهای سطحی و رسیدن به نوعی فهم عمیق و بنیادی از پدیدهها، همانند آنچه در تاریخ علم رخ داده است.
توهم فهم در مدلهای هوش مصنوعی
سندهیل مولینیتن، اقتصاددان و دانشمند علوم کامپیوتر در MIT، به همراه کیون وفا و گروهی دیگر، چند منظومهی مصنوعی ساختند که در آن سیارهها بر اساس قوانین مکانیک نیوتن حرکت میکردند. پس از آموزش یک مدل بر روی مسیرهای این سیارات، از آن خواستند حرکت بعدی هر جرم را پیشبینی کند. در این آزمایش، مدل توانست مسیر حرکت سیارات را با دقت بسیار بالا پیشبینی کند، اما سوال اصلی این بود که آیا این مدل، قوانین بنیادی و مشترک حرکت آنها را درک کرده است یا صرفاً الگوهای آماری را یاد گرفته است.
در ادامه، گروه آزمایشهای جدیدی انجام دادند تا توانایی مدل در انتقال دانش به شرایط جدید را ارزیابی کنند. اگر مدل واقعاً قانون حرکت را فهمیده باشد، باید بتواند آن را در موقعیتهای جدید نیز به کار گیرد، همانطور که یک دانشمند پس از فهم یک اصل، آن را در مسائل تازه به کار میبرد. اما نتایج نشان داد که مدل مسیر سیارات را به خوبی پیشبینی میکند، اما در توضیح نیروی محرکهی مدارها، به نتایج متفاوتی رسید. نمودار سمت چپ، نیروی واقعی گرانش را نشان میدهد، در حالی که خطوط صورتی در نمودار سمت راست، نیروی پیشبینیشده توسط مدل را نمایش میدهند.
نتیجه این آزمایش، حیرتانگیز بود. مدل به جای کشف یک قانون عمومی، برای هر منظومهی سیارهای، قاعدهای جداگانه ساخته بود. به عبارت دیگر، ماشین توانسته بود مسیر حرکت سیارات را پیشبینی کند، اما پشت این پیشبینی، قانون مشترک و کلی برای تمامی منظومهها وجود نداشت. این یافته نشان میدهد که مدلهای هوش مصنوعی، بیشتر شبیه نقشهبرداران خوبی هستند که مسیرهای طیشده را حفظ میکنند، نه فهم ساختار کلی و قوانین حاکم بر سیستمها.
میتوان این تفاوت را با دو نوع نقشه مقایسه کرد: نقشهای که فقط مسیرهای قبلی را نشان میدهد و بر اساس آن، مسیرهای آینده را حدس میزند، و نقشهای که ساختار و الگوی شهر را نشان میدهد، و به ما امکان میدهد در مسیرهای ناآشنا نیز حرکت کنیم. در این تشبیه، مدل سیارهها بیشتر شبیه نقشهی اول است، که تنها الگوهای دیدهشده را بازتولید میکند، نه فهم عمیق قوانین حاکم بر حرکتها.
مطالعات وفا و همکارانش نشان میدهد که تفاوت میان توانایی پیشبینی دقیق و درک مفهومی قانون، بسیار است. مدلها میتوانند پاسخهای آماری و پیشبینیهای دقیقی ارائه دهند، اما فهم علمی به درک قوانین عمومی و قابل انتقال نیاز دارد. با این حال، پیشرفتهای اخیر در حوزه هوش مصنوعی و ریاضیات نشان میدهد که راهحلهای جدیدی در حال ظهور هستند که میتوانند این مرز را جابهجا کنند و به فهم عمیقتر و قانونمندتر از سیستمهای پیچیده برسند.
پیشرفتهای نوآورانه در حل مسائل ریاضی و محدودیتهای آن
در ماه مه سال ۲۰۲۶، یک مدل داخلی از OpenAI توانست با یافتن نمونه نقضی برای فرضیهای هشتادساله، توجه جامعه ریاضی را مجدد جلب کند. این دستاورد نشاندهنده تواناییهای فزاینده هوش مصنوعی در کشف الگوها و حل مسائل پیچیده است. نمونهای از این پیشرفتها، مسئله فاصله واحد در مجموعه نقاط است که در آن، حدس اردوش در مورد تعداد جفتهای فاصلهدار، مورد آزمایش قرار گرفت.
پرسش این بود که اگر تعدادی نقطه روی صفحه قرار گیرد، چند جفت از آنها میتوانند دقیقا یک واحد فاصله داشته باشند؟ گروهی از ریاضیدانان با کمک مدلهای پیشرفته، توانستند راهحلی پیدا کنند که مرزهای پیشبینیشده را پشت سر گذاشت و نمونههایی را ارائه دهند که حدس قبلی را رد میکردند. این نشان میدهد که ماشینها میتوانند درک و خلاقیت جدیدی در پیوند دادن ابزارهای ریاضی نشان دهند، هرچند هنوز فاصلهای عظیم با اکتشافات انقلابی مانند نظریه نسبیت عام دارند.
فاصله میان نوآوریهای ماشین و انقلابهای علمی بزرگ
در حالی که ماشینها میتوانند اثبات کنند که خلاقاند و مفاهیم جدیدی را ترکیب کنند، هنوز راه زیادی تا رسیدن به سطح ابداعات انقلابی مانند اینشتین باقی مانده است. نظریه نسبیت عام، که جهان را از فضا و زمان گرفته تا مفهوم گرانش، دگرگون ساخت، نمونهای است از تغییر پارادایمهای علمی که در آن، شیوههای تفکر و درک ما به طور بنیادی تغییر یافته است.
مرز میان ترکیب ابزارهای موجود و خلق مفاهیم جدید همیشه مبهم است. دانشمندان انسانی نیز معمولاً بر پایهی دانش، مسئلهها و ابزارهای پیشین کار میکنند، اما در هر صورت، این روند منجر به پیشرفتهای قابل توجه میشود. در حوزهی ریاضیات، ارزیابی نتایج ماشینها آسانتر است، زیرا میتوان نتیجهها را دقیقاً بررسی و صحت آنها را ارزیابی کرد. یک نمونه نقض یا حدس، میتواند استدلالهای ماشین را رد کند یا مشکلاتی در مسیر اثبات نشان دهد.
چالشهای حوزه فیزیک و محدودیتهای مدلهای هوشمند
در فیزیک، کار پیچیدهتر است؛ زیرا گاهی دو نظریه میتوانند دادههای موجود را تفسیر کنند و تفاوت آنها تنها در آزمایشهای بعدی مشخص میشود که ممکن است ساخت آنها سالها طول بکشد. قبل از رسیدن به چنین آزمایشهایی، محققان با چالش بنیادیتری مواجه هستند: ساخت مدلی که تنها دانش یک دوره خاص را در بر گیرد. این محدودیت، اجرای آزمایشهای انقلابی مانند آنچه اینشتین انجام داد را بسیار دشوار میکند.
در نتیجه، توسعهی چنین مدلهایی نیازمند درک عمیق و دقیق از محدودیتها و امکانات موجود است، چرا که تنها با شناخت کامل مرزهای دانش در آن دوره، میتوان به درستی مسیر پیشرفت علمی را ترسیم کرد. بنابراین، هر چند هوش مصنوعی در حال حاضر تواناییهای قابل توجهی دارد، اما هنوز فاصله زیادی تا رسیدن به اکتشافات انقلابی مانند نظریه نسبیت عام باقی است، و این مسیر نیازمند تفکر عمیق و خلاقانه است که عمدتاً انسانی باقی میماند.
چگونه میتوان آینده را از حافظهی مدلها پاک کرد؟
پژوهشگران در حوزه هوش مصنوعی همواره با چالش حفظ صحت و دقت مدلهای زبانی روبهرو هستند، به ویژه زمانی که نیاز است دادههای قدیمی یا نادرست حذف شوند. مایکل هلا، محقق مستقل در سانفرانسیسکو، اقدام به ساخت نسخهای واقعی از آزمونهای مبتنی بر حافظه کرد و آن را «ماشینا میرابیلیس» نامید؛ نامی که به سال معجزهآسای ۱۹۰۵ و انتشار چهار مقالهی مهم اینشتین اشاره دارد. هلا مدل زبانی خود را با متون پیش از سال ۱۹۰۰ آموزش داد و سپس آن را به سمت مفاهیم مکانیک کوانتومی و نسبیت هدایت کرد.
در فرآیند آموزش، هلا از راهنماییهایی بهره برد که به نزدیکتر شدن مدل به مفاهیم علمی کمک میکردند. برای مثال، در یکی از آزمایشها، مدل به مشاهده اثر فوتوالکتریک پرداخت، پدیدهای که در آن نور، الکترونها را از سطح فلز جدا میکند. مدل پیشنهاد داد که نور به بستههای مجزا و جداگانه تقسیم میشود، مفهومی که شبیه به تصور بستههای انرژی است. این نشان میدهد که حتی اشتباهات کوچک در دادهها میتواند نتایج نادرستی در آزمونهای تاریخی مدل ایجاد کند.
در آزمایش دیگری، مدل وارد یک فرضیه خیالی شد که شبیه به آزمایش فکری اینشتین دربارهی آسانسور است. در این آزمایش، مسافری در داخل یک اتاقک بسته احساس میکند که نیرویی روی بدنش اعمال میشود، و این تجربه میتواند ناشی از گرانش یا شتاب آسانسور باشد. این تصویر به مدل کمک کرد تا اصل همارزی را در مقیاس کوچک توصیف کند و گرانش و شتاب را به صورت همارز بیان کند. هلا معتقد بود که پاسخهای مدل، در واقع، نشانههایی از شهود و درک اولیه هستند، اما فاصله زیادی تا کشفهای علمی در ابعاد نسبیت داشتند. بسیاری از مسیرهای پژوهشی به بنبست میرسیدند و مدل گاهی جملاتی تولید میکرد که ظاهراً علمی بودند، اما در واقع تصویر منسجمی از جهان ارائه نمیدادند. سرنخهای کلیدی در این فرآیند، توسط محقق وارد گفتوگو میشدند.
ساخت ماشین زمانی که واقعاً آینده را فراموش کرده باشد، در واقع دستکم با کشف علمی تفاوتی ندارد. پژوهشگران باید تاریخ و منشا تقریبی تمامی دادههای آموزشی را بدانند. وقتی مدلی صدها میلیارد قطعه متن را مطالعه میکند، انجام چنین کاری بسیار دشوار و حتی غیرممکن میشود.
نیک لوین بر این باور است که مدلهای تاریخی، حتی برای پیشبینیهای کوتاهمدت، مفید هستند. برای مثال، پژوهشگران میتوانند آموزش مدل را در یک بازه زمانی خاص متوقف کرده و سپس بررسی کنند که آیا توانسته است کشفهای مربوط به ماه ژوئن را پیشبینی کند یا خیر. هرچه فاصله زمانی کوتاهتر باشد، کنترل دادهها آسانتر است و آزمایشهای مجدد نیز سادهتر صورت میگیرند. تیم دانشگاه زوریخ نیز روشی مشابه را با مدلهای سری Ranke-4B دنبال میکند، که هر یک تنها تا تاریخهای مشخص، یعنی سالهای ۱۹۱۳، ۱۹۲۹، ۱۹۳۳، ۱۹۳۹ و ۱۹۴۶، دانش دارند. هدف این است که نشان دهند مدلها گاهی میتوانند نشانههایی از نبوغ و پیشبینیهای آینده را نشان دهند، هرچند این توانایی محدود و وابسته به دادههای آموزشی است.
پاکسازی دادهها تنها بخش اول فرآیند است. اهمیت بیشتری در این است که بدانیم مدل چقدر ایدههای جدید و ارزشمندی پیشنهاد میدهد و چه میزان از کشفیات آن، نتیجهی آموزش بر روی دادههای آموزشی است. در مرحله بعد، باید ارزیابی کنیم که کدام یک از حدسهای مدل، ارزش صرف وقت، هزینه و محاسبه را دارند و کدامها تنها سرنخهای بیارزش هستند. این فرآیند، یکی از چالشهای اصلی در توسعه هوش مصنوعی است و نقش حیاتی در پیشرفت علم دارد. در نهایت، پاکسازی کامل دادهها و کنترل دقیق بر روی آنها، مدلها را در مسیر کشفهای نوین و پیشرفتهای علمی قرار میدهد، اما این کار نیازمند دقت، دانش و رویکرد علمی است که بتواند میان حدسهای ارزشمند و بیارزش تمایز قائل شود.
نوآوری آسان است؛ انتخاب ایدهی ارزشمند دشوار
جیکوب آندریاس، دانشمند علوم کامپیوتر در MIT، بر این باور است که مدلهای زبانی ممکن است بتوانند نظریههایی در ابعاد نسبیت ارائه دهند. یک مدل بزرگ میتواند صدها فرضیه مختلف برای مجموعهای از مشاهدات ارائه دهد و شاید بتواند میان آنها چارچوبی معادل با نظریه نسبیت عام بیابد. اما در میان این فرضیهها، کدام یک ارزش پیگیری دارد؟
نویسندگان مقاله «آیا هوش مصنوعی میتواند راه اینشتین را ادامه دهد؟» این فرآیند را «سلیقهی علمی» مینامند. در این فرآیند، پژوهشگر باتجربه از میان انبوه فرضیهها، مسیری را انتخاب میکند که هم از نظر پیامدهای علمی مهم باشد و هم قابل آزمایش باشد. تجربه، شناخت تاریخ علم و محدودیتهای عملی، کمک میکنند تا فرضیههای کمثمر زودتر کنار گذاشته شوند.
«سلیقه علمی» حلقه مفقودهای است که هوش مصنوعی را از دانشمند واقعی متمایز میسازد.
در زمان آلبرت اینشتین، او میتوانست پارامترهای جدیدی به نظریه نیوتون اضافه کند یا نظریه ولکان را بپذیرد تا توضیح حرکت عطارد را بهتر کند. اما او مسیر دشوارتری را دنبال کرد؛ فرضیهای نوآورانه، که اهمیت آن تنها در معرفی ایدهای عجیب نبود، بلکه در دنبالکردن فرضیه گرانش و هندسه فضا-زمان، سنجش پیامدهای آن و پیدا کردن راههایی برای آزمودن آن نهفته بود.
مدلهای زبانی میتوانند هزاران فرضیه جدید تولید کنند، اما مشکل این است که کدام یک ارزش پیگیری دارد. ماشین باید توانایی تشخیص دهد کدام فرضیه پتانسیل کشفهای مهم را دارد. مطالعه متون علمی تنها بخشی از فرآیند پرورش این توانایی است و برای توسعه آن کافی نیست.
علم در کتابها ثبت میشود، اما درباره جهان واقعی صحبت میکند. مدلی که بتواند آزمایشهایی پیشنهاد کند، نتایج را تحلیل کند و بر اساس آن استنتاجهای جدیدی ارائه دهد، از محدودیتهای مطالعه صرف در آرشیو علم فراتر میرود و وارد مرحلهای جدید میشود.
از آرشیوخوانی تا بازتعریف مسئله؛ ورود ماشین به چرخه آزمایشهای واقعی
نمونهای از چیدمانهای اپتیکی که الگوریتم MELVIN طراحی کرده است، شامل طرحهایی است که برای ساخت حالتی درهمتنیده میان سه فوتون طراحی شدهاند. این طرحها، هرچند پیچیده و نامتقارن، مسیرهای حرکت فوتونها را نشان میدهند و در آنها نمادهای مختلفی مانند آینه، هولوگرام، بلور و آشکارساز به کار رفته است.
مدتها پیش، ماریو کرن، فیزیکدان و پژوهشگر هوش مصنوعی، برنامهای به نام MELVIN توسعه داد که قادر بود اجزای آزمایشهای اپتیک کوانتومی را در ترکیبهای مختلف کنار هم قرار دهد. این الگوریتم، هزاران آرایش مختلف را آزمایش میکرد و فرضیههایی که پس از حذف آرایشهای کمفایده باقی میماندند، برای فیزیکدانان عجیب بودند، اما در عمل، کار میکردند. این خروجیها منجر به کشفهای جدید در دستکاری حالتهای کوانتومی شدند.
ماشینها حالا فراتر از خواندن متون علمی، خودشان میتوانند آزمایشها را هدایت کنند. نسل جدید ابزارهایی مانند MELVIN، دامنه فعالیت وسیعتری دارند و میتوانند آزمایشهایی پیشنهاد دهند، آنها را اجرا کنند، نتایج را اندازهگیری و تحلیل کنند و بر اساس دادههای جدید، آزمایش بعدی را طراحی نمایند. این فرآیند، ماشین را قادر میسازد تا مستقیماً در طبیعت آزمایش کند، نه فقط در حد تحلیل اطلاعات موجود.
با این حال، انسانها همچنان نقش مهمی در تعیین مسئله و معیارهای موفقیت دارند. پیدا کردن بهترین آزمایش برای هدف مشخص، با فرآیندهای انسانی متفاوت است. شاید در آیندهای نزدیک، ماشینی بتواند مسئله را بازتعریف کند و از نتایج غیرمنتظره، چارچوب جدیدی برای فهم جهان بسازد.
قبولی در آزمون اینشتین چه شکلی خواهد داشت؟
به اعتقاد هاسابیس، آزمون اینشتین یعنی اینکه ماشینی با دانش و مفروضات سال ۱۹۱۱ بتواند به کشفی در حوزه نسبیت عام در سال ۱۹۱۵ دست یابد. اما پژوهشگرانی که این مسیر را طی کردهاند، معیار قبولی در این آزمون را تنها در حلکردن چند معادله نمیدانند.
مدل باید بتواند بر اساس دادههای گذشته آموزش ببیند و مسیر کشف را با توجه به مسئلهها، مشاهدات و ابزارهای فکری همان دوره پیدا کند. شاید اولین ماشینی که بتواند این آزمون را با موفقیت پشت سر بگذارد، مسیری متفاوت از روشهای انسانی طی کند. اما در نهایت، باید بتواند پدیدهها را توضیح دهد، پیشبینیهای قابلسنجش ارائه کند و از صحت این پیشبینیها اطمینان حاصل شود؛ بهگونهای که کشفهای آن، نتیجه نشت دادههای آینده یا دستکاری ناپیدای پژوهشگران نباشد.
ارزش واقعی کشفهای هوش مصنوعی در آن است که، پس از خروج از فضای نمایشگر، بتواند پدیدهها را به طور جسورانه پیشبینی کند و در صورت تطابق با جهان واقعی، نشان دهد که این کشف، نتیجه استنتاجهای علمی مستقل و قابل اعتماد است.